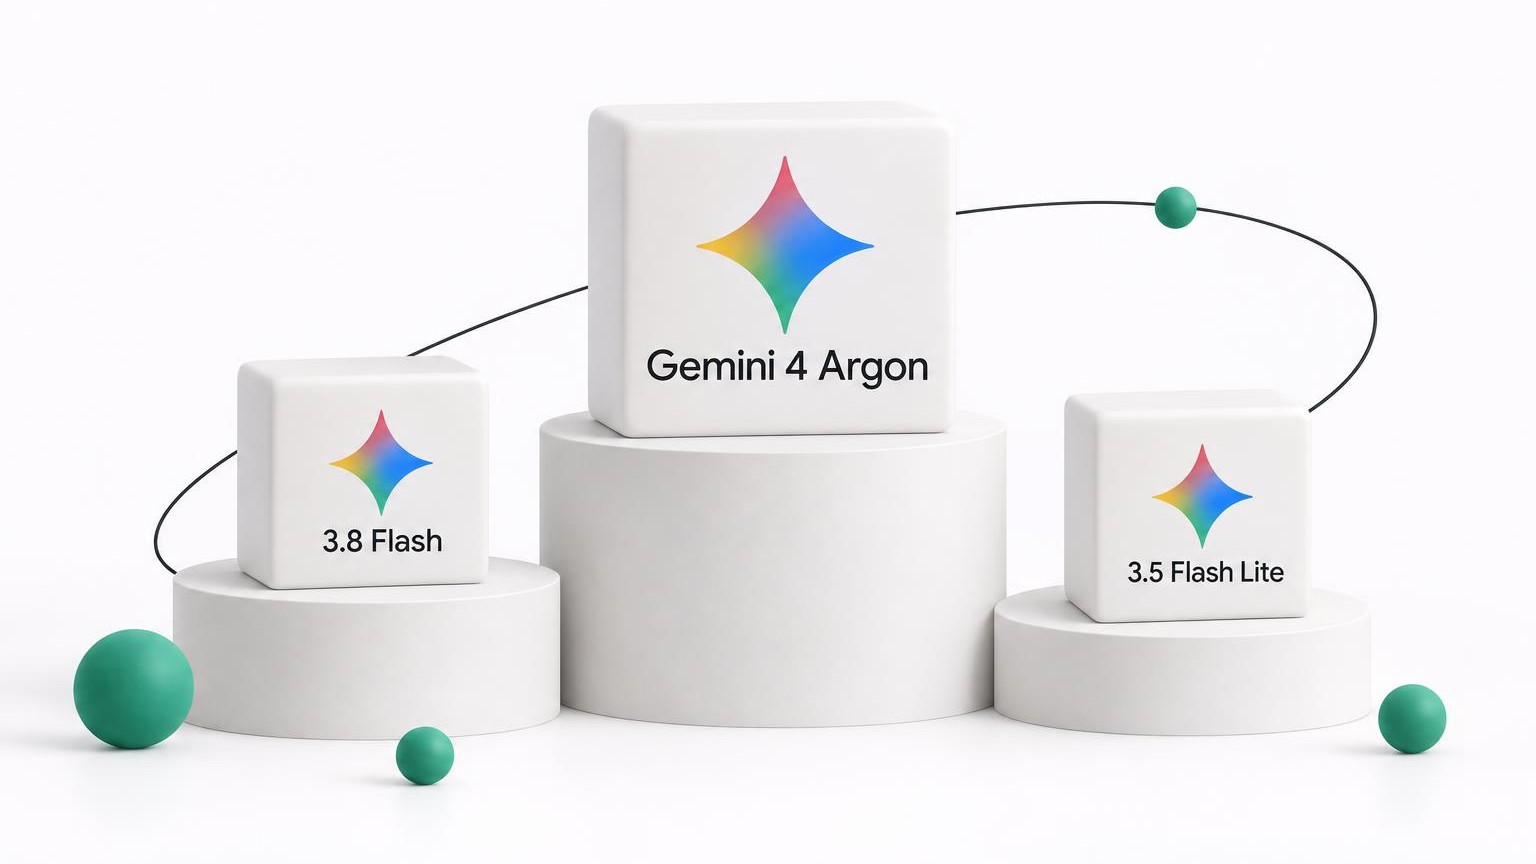
Il 13 ottobre 2026 Google ha presentato Gemini 4 Argon, il primo modello della nuova famiglia Gemini 4. Su ChatX Argon è ora il modello Gemini più potente. Accanto restano Gemini 3.8 Flash come tuttofare e Gemini 3.5 Flash Lite come variante economica. Qui trovi dove Argon è in testa, dove no e per quali compiti conviene ciascuno dei tre modelli.
Che cosa distingue Gemini 4 Argon
Nell’annuncio Google descrive Argon come il modello per i compiti più difficili («built to solve your hardest problems»). Si parla di analisi lunghe, codice impegnativo, matematica e domande scientifiche.
Nell’uso quotidiano contano tre caratteristiche:
- Contesto molto lungo: input e output possono arrivare insieme fino a 1 milione di token. Basta per documenti molto lunghi o per cronologie di chat corpose.
- Conoscenze aggiornate: secondo la scheda del modello, le sue conoscenze arrivano a marzo 2026. Per tutto ciò che è più recente, su ChatX attivi la ricerca web.
- Immagini come input: puoi caricare foto, screenshot o diagrammi e fare domande su quello che mostrano.
Argon ragiona prima di ogni risposta. Quanto a fondo lo decidi tu su ChatX con i livelli Bassa, Media e Alta. Per questo modello l’opzione «Disattivata» non esiste. ChatX non mostra i passaggi del ragionamento, che però rientrano nel conteggio dei token.
A fine ottobre Google ha già annunciato un modello ancora più potente, Gemini 4 Carbon. Per ora è accessibile solo a partner selezionati del settore sicurezza e quindi su ChatX non è in programma.
Benchmark: spesso in testa, ma non ovunque
I valori vengono dalla scheda del modello pubblicata da Google a ottobre 2026. Per confronto trovi accanto tre modelli che conosci già da ChatX.
| Test | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Lavoro intellettuale (Vals Index) | 68,9% | 63,1% | 65,8% | 67,0% |
| Programmazione (DeepSWE v1.1) | 77,9% | 74,1% | 67,4% | 74,2% |
| Testi molto lunghi (GraphWalks, da 256k a 1M) | 84,2% | 71,8% | 65,0% | 66,8% |
| Comprensione di video lunghi (LVBench) | 91,7% | 87,5% | 79,7% | 83,7% |
| Programmazione (FrontierSWE v2) | 55,0% | 65,5% | 56,3% | 62,3% |
| Lavoro nel terminale (Terminal-bench 4.0) | 57,4% | 58,2% | 57,9% | 66,4% |
Il vantaggio più netto è sui testi molto lunghi: con input tra 256.000 e 1 milione di token Argon stacca il secondo modello di oltre dodici punti. È un buon segno per chi vuole dargli in pasto un manuale voluminoso o tanti file in una volta sola.
Nella programmazione il quadro è meno netto. In DeepSWE è in testa Argon, in FrontierSWE v2 e Terminal-bench 4.0 sono davanti GPT-6 Astra e Claude Opus 5.5. Ci sono poi due cose da sapere: i numeri li ha pubblicati Google stessa. E Claude Fable 5.2, disponibile dal 9 novembre, nella tabella ancora non c’è.
Argon, 3.8 Flash o Flash Lite?
Su ChatX ora puoi scegliere tra tre modelli Gemini. Si distinguono soprattutto per accuratezza e prezzo.
| Modello | Pensato per | Accesso |
|---|---|---|
| Gemini 4 Argon | compiti difficili, documenti lunghi, codice complesso | account gratuito |
| Gemini 3.8 Flash | uso quotidiano: testi, analisi, traduzioni, codice | account gratuito |
| Gemini 3.5 Flash Lite | domande semplici e veloci, testi brevi | senza registrazione |
Gemini 3.8 Flash è sul mercato dal 2 settembre 2026. Google lo definisce il suo modello da lavoro più intelligente («our most intelligent workhorse model»). Per la maggior parte delle domande è la scelta più sensata. Flash Lite puoi provarlo subito, senza registrarti.
La nostra prova: tre compiti, tre modelli
Abbiamo dato ai tre modelli Gemini gli stessi compiti: un problema di matematica con due treni, una breve e-mail al padrone di casa e una funzione PHP per la verifica dell’IBAN. Ogni modello ha girato una volta con le impostazioni predefinite, quindi Argon e 3.8 Flash con il ragionamento su Bassa.
| Compito | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash Lite |
|---|---|---|---|
| Problema di matematica | 13,4 secondi, circa 1.500 token | 9,7 secondi, circa 1.000 token | 2,1 secondi, circa 370 token |
| E-mail al padrone di casa | 7,9 secondi, circa 450 token | 3,4 secondi, circa 170 token | 1,2 secondi, circa 100 token |
| Verifica dell’IBAN in PHP | 9,7 secondi, circa 1.300 token | 4,7 secondi, circa 440 token | 1,4 secondi, circa 220 token |
Nel problema di matematica Argon e 3.8 Flash sono arrivati al risultato giusto: i treni si incrociano poco dopo le 10:10. Flash Lite ha sbagliato i calcoli e ha indicato le 10:29. Argon ha anche verificato il risultato con una prova. L’e-mail era utilizzabile con tutti e tre i modelli. Per compiti del genere basta Flash Lite, che ha finito in poco più di un secondo.
Il test è un campione, con un solo passaggio per compito. Lo schema però si vede: Argon ci mette di più e costa di più, ma nel problema di matematica più insidioso ha dato la risposta più accurata.
Quanto costa una risposta su ChatX
ChatX calcola il consumo in base ai costi reali presso il fornitore. Nel nostro test una risposta di Argon è costata tra circa 450 e 1.500 token, con 3.8 Flash da circa 170 a 1.000 token e con Flash Lite da circa 100 a 370 token. A seconda del compito, quindi, Argon costa da una volta e mezza a tre volte 3.8 Flash. In una chat più lunga si aggiunge come input la conversazione precedente. Con i livelli Media e Alta il modello ragiona più a lungo e il consumo sale sensibilmente.
Importante per fare i conti: Google offre Argon a prezzo di lancio fino al 30 novembre 2026. Dal 1º dicembre Google raddoppia il prezzo. A quel punto anche su ChatX verrà scalato il doppio del credito, nel nostro test quindi da circa 900 a 3.000 token per risposta. Per Gemini 3.8 Flash il prezzo di lancio termina a fine anno.
Consigli per iniziare
- Prima Flash, poi Argon: fai la tua domanda prima a Gemini 3.8 Flash. Se la risposta non basta, passi ad Argon nella stessa chat.
- Bassa per i testi: e-mail, riassunti e traduzioni non richiedono lunghi ragionamenti. Così risparmi token.
- Alta per i casi difficili: calcoli complicati, ricerca di errori nel codice o il confronto tra più documenti lunghi sono il terreno per cui Argon è stato costruito.
- Ricerca web per i temi di attualità: le conoscenze di Argon si fermano a marzo 2026. Per notizie, prezzi o nuovi prodotti attiva la ricerca web.
- Interroga in modo mirato i documenti lunghi: stando ai benchmark, è qui che Argon dà il meglio. Più l’input è lungo, però, più token costa ogni messaggio.